「我们只有一次机会。」
回顾 2023 年创业时的处境,XHEART 新芯航途 CEO 李宗霖这样形容。
彼时,智驾芯片市场已经不缺玩家,XHEART 却决定从头造一颗。
英伟达 Orin-X 凭借 254 TOPS 算力,和 CUDA、TensorRT 等成熟的软件生态,稳居高阶智驾市场主流。
地平线依靠 BPU 架构和征程系列芯片,在国内车企供应链中站稳脚跟。
蔚来、小鹏、理想等车企则纷纷投入自研芯片,希望将智驾算法与底层硬件更紧密地结合起来。
一边是拥有成熟产品与软件生态的芯片供应商,一边是希望掌握核心技术的车企。
留给后来者的机会,看起来已经不多。
即使芯片做出来,又如何说服车企放弃成熟供应商,重新投入模型迁移、域控制器设计和整车验证?对车企而言,换一颗芯片,远不是换一个零件那么简单。
但在李宗霖看来,2023 年是一个「极佳的机会点」。
摆在 XHEART 面前的第一个问题,并不是如何造出一颗算力更大的芯片,而是市场已经有这么多成熟芯片,为什么还需要重新造一颗?
01
模型变了,芯片也要重新设计
「做芯片的人首先要搞清楚,这颗芯片的用户是谁。」
李宗霖给出的答案是:在智能驾驶领域,用户就是算法模型。
而正是模型的改变,打开了 XHEART 的窗口。
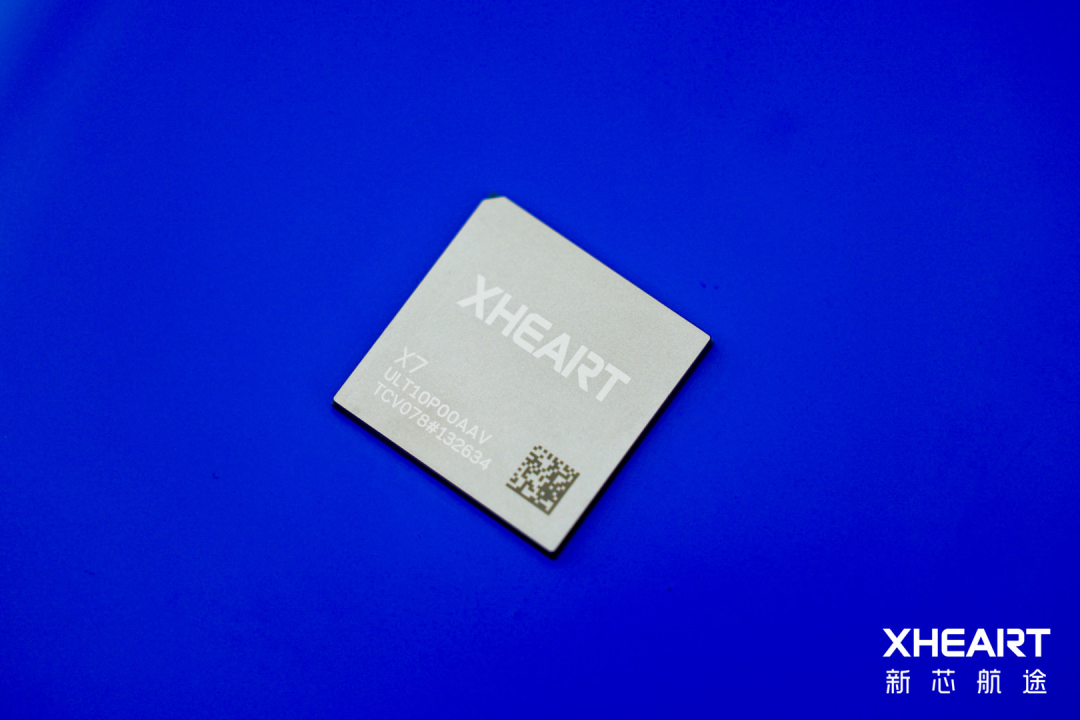
过去的智能驾驶系统,更像是一支分工明确的团队。感知负责识别道路,预测负责判断其他车辆的行为,规划再决定下一步怎么走。
不同小模型各司其职,芯片则像一个调度员,用多核、异构计算等方式,把不同类型的任务分派给不同的计算单元。
但端到端大模型正在改变这种分工。原本相对独立的感知、预测、规划任务,越来越多地被整合进统一神经网络。
尤其 Transformer 架构的广泛应用,让矩阵计算、数据交互以及存储访问的需求发生变化。
蔚来智驾负责人任少卿曾分享,在特定计算量下,Transformer 对内存带宽的需求,可能达到 CNN(卷积神经网络)的 8 至 70 倍。相当于干同样多的活,Transformer 需要芯片搬运的数据要多很多。
模型换了,芯片也要跟着优化。此前主要面向 CNN 等计算负载优化的部分芯片架构,虽然能够运行 Transformer,却未必能让新模型发挥出最优效率。所以这是新玩家的机会,可以绕开原来的路径,围绕下一代的模型来设计芯片。
一颗芯片在车上的表现到底怎么样,不能只看表面参数。芯片在真实任务里的处理速度和能耗,主要受三个因素影响:
第一,是芯片本身的计算能力,也就是行业最熟悉的 TOPS 指标。计算单元越多、运算越快,理论上能完成的任务就越多。
第二,是这些计算资源究竟能用上多少。大模型运行时,计算单元要不断读取权重、处理输入,再把中间结果交给下一步。
第三,是算法使用计算资源的效率。硬件够强、计算单元也能持续工作,但如果模型本身存在大量重复计算,或者软件部署方式不够合理,推理速度照样会被拖慢。
反过来,模型优化、算子融合、编译器和工具链改进,也能让同样的硬件完成更多有效计算。
这给芯片提出了新的要求,AI 推理阶段,除了保障充足算力,大模型还需缩短整个芯片系统内的数据搬运路径,它直接影响两件事:
性能上,如果芯片设计没有针对大模型的特性,数据就会在芯片上反复搬运,芯片需要花大量时间等待数据;
功耗上,数据搬运过程会产生很大功耗,把散热压力传递到域控制器乃至整个系统。
从百 TOPS 到千 TOPS,理论算力不断增长,如何让这些算力真正发挥作用,就成了一道比单纯增加计算资源更复杂的题。
图灵奖得主杰克·唐加拉表示,三十年前,浮点运算成本极高;今天,机器浮点算力普遍过剩,真正的瓶颈变成了数据搬运。需要转向新基准,来匹配当下的架构,以及衡量系统性能。
放到车端芯片上,「TOPS/W」(每瓦功耗提供多少算力)等纸面指标之外,还要看实际表现:
目标响应时间下的系统功耗,
持续负载下的性能与温度变化。
通过模型、芯片与整车热管理的协同,让驾驶能力在不同车型上稳定运行。
于是,与其沿着成熟厂商过去的路线追赶,不如直接从未来模型出发设计芯片。XHEART 决定做一款面向大模型的通用芯片架构,围绕智驾大模型,从架构定义阶段就引入真实模型需求。
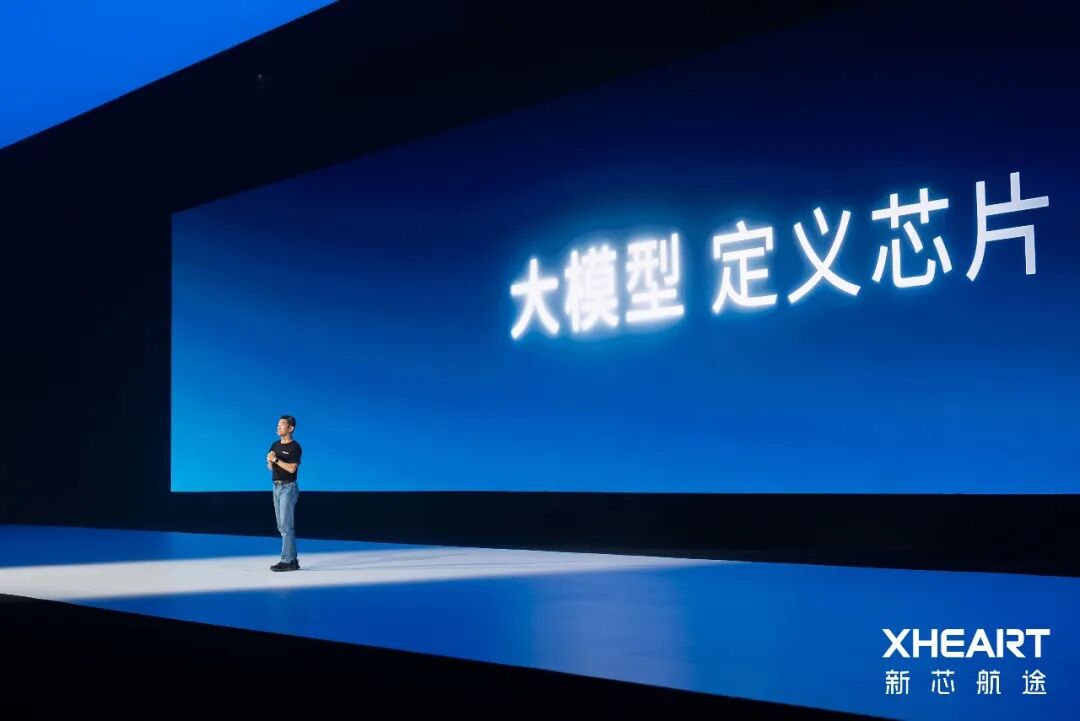
当然,提前押注未来模型,同样意味着风险。
一方面,算法迭代与芯片开发并不同步。模型可能几个月就经历一次重要迭代,一颗车规芯片,从架构定义、流片到量产上车,往往需要数年。等芯片真正装车,原本面向的智驾模型,可能已经经历了数轮迭代。
另一方面,在芯片行业,越往研发后期推进,资金和人力投入越高。一旦完成流片,再想改变底层架构,代价往往难以承受。对于 XHEART 这样的后来者,这几乎是一场没有多少试错余地的下注。这也是李宗霖说的「只有一次机会」。
XHEART 的解法是,把模型与硬件之间的磨合往前移,让未来上车的算法,在芯片流片之前就参与检验。
这里的关键合作伙伴是 Momenta。在架构设计初期,XHERAT 就依托 Momenta 的算法趋势判断,推动算法模型与芯片架构的联合定义和同步迭代。
在这套系统机制中,Momenta 带来的不只是一个现成的模型,还有来自量产一线的计算特征和算法演进方向,比如未来的大模型大概会长什么样,哪些计算最吃资源,XHEART 则以此为输入,独立完成芯片架构、存储带宽和工具链设计。
XHEART 选择的并不是一条更轻松的路,而是主动收窄战场,把未来几年押在对智驾大模型计算需求的理解上。
过去,芯片决定模型能够做到什么;如今,模型开始反过来决定芯片应该怎么造。
02
超大核,让算力少走「冤枉路」
看到了新的计算需求,还要找到最合适的芯片架构。
XHEART 内部曾为下一代 NPU(Neural Processing Unit,神经网络处理单元)究竟怎么设计,经历过相当大的分歧。
团队评估了多种架构方案,每套方案都对应不同的数据流结构,需要通过性能建模和仿真反复验证,进行量化评估。
最终,团队把筹码押在了超大核 NPU 上,瞄准的是数据交接这一项开销。
灵活的小核架构,遇上大模型,反而增加了数据交接的负担。受限于单核算力,大模型必须被拆分成多个子模型运行,会带来巨大的数据搬移量,整体效率大幅降低。
这就像一条生产线,工人效率很高,但半成品需要反复送往不同车间。真正拖慢生产的,是工件一直在路上。
XHEART 选择超大核,减少的正是这部分开销。整套端到端大模型可以在单颗大核内完整运行,让数据尽可能通过大核内部的高速互联与多级缓存流转。
X7 Ultra 把部分原本发生在不同小核之间、百 GB/s 级的数据交互,转化为大核内部 TB/s 级的高速交换。
超大核减少了模型拆分带来的数据交接,具体到每一步运算,数据还可以走得更短。
Transformer 运行过程中,除了大规模矩阵计算,还会反复调用 Softmax、转置(Transpose)、Layer Norm 等算子。
如果这些操作频繁访问外部 DDR 内存,数据传输就可能受到内存带宽限制,拖慢整体推理。
因此,XHEART 在硬件架构层面为这些算子做了精细化适配,让相关数据尽可能就近处理,部分操作可以省去往返 DDR 的过程,甚至在寄存器级别完成。
这样一来,芯片对外部内存传输的依赖降低,后续部署的模型也更不容易被内存带宽卡脖子。
据 XHERAT 披露,基于真实量产 Transformer 智驾模型实测,NPU 计算利用率达到 98.7%。
这相当于,在这项测试中,计算单元绝大部分时间都在干活,而不是在等数据。
模型进芯片,中间还要经过编译、量化和仿真等工具链。
硬件架构选定之后,模型怎样高效部署、怎样用好计算资源,还要看工具链。
XHEART 从芯片设计初期,就把 AI 工具链纳入考量:
一方面,提高当前模型的部署效率。通过「整网级融合」和「内存零拷贝技术」,降低数据延迟与 DDR 带宽消耗。
另一方面,承接后续模型变化。新的模型能否顺利转换、部署到旧的硬件架构上,并保持效率,关系到车企能否在这套平台上继续推进智驾升级。
当前模型跑得快,是一次适配的结果。
模型更新之后还能跟得上,才能体现平台的持续价值。芯片一旦量产,硬件就基本定型了,但模型还会不断变化。后续的性能提升,很大程度要靠编译器、算子库和工具链持续释放。
经过整体软硬协同,XHEART 给出基于国创中心对标评测的 700 TOPS 大模型算力。700 TOPS 是真实量产模型实测结果,不是实验室 Demo 跑出的结果。
XHEART 同时披露,在大模型性能相当的测试条件下,相较于其选取的行业旗舰产品,X7 Ultra 内存带宽消耗降低 80%,推理能效提升 100%,也就是能效翻倍。
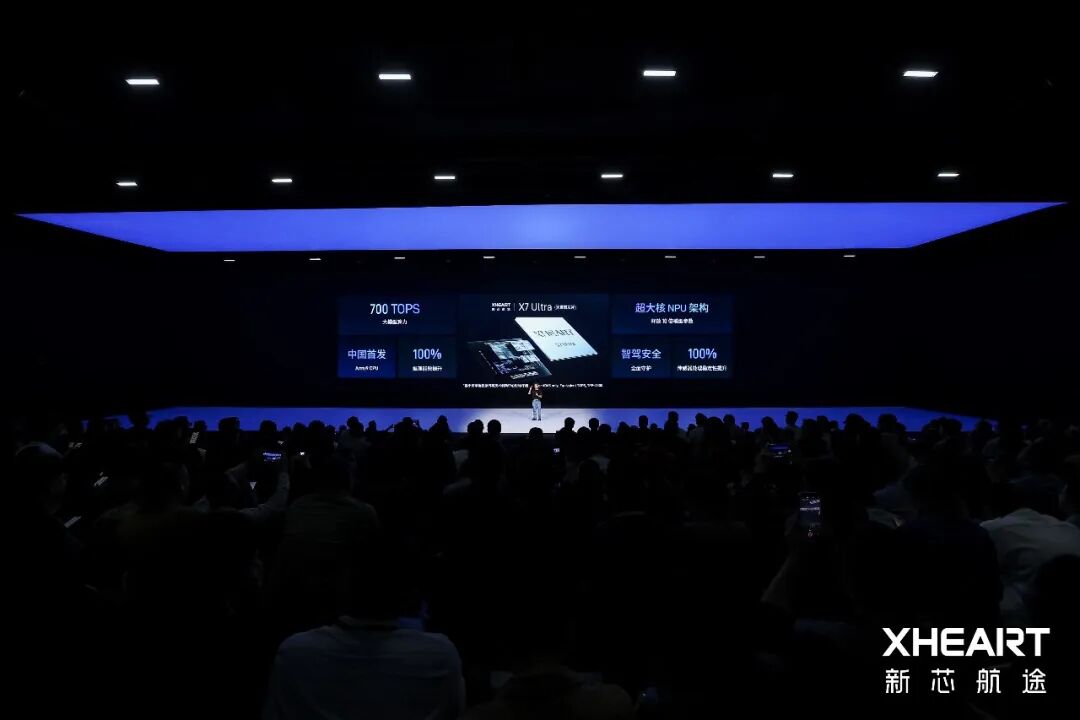
对车企而言,高效率意味着在有限硬件条件下,有机会部署更复杂的模型,并为后续能力升级留出空间。
从这个角度看,XHEART 证明的不只是一次大核架构选择,更是围绕真实模型组织硬件与软件的一套方法,既要让当前大模型运行得足够高效,又要确保未来模型变化时,芯片仍有适配和升级的空间。
03
智驾芯片,上车见真章
芯片是一门规模生意。
研发、流片、工具链开发和车规验证都需要持续投入。量产之后,单颗芯片能留下多少毛利、出货能否持续增长,决定这些投入能否被覆盖。
这也让车企自研芯片开始走出自家车型。
理想汽车总裁马东辉表示,马赫芯片可以对外供应,有助于摊薄研发成本;小鹏图灵 AI 芯片已获得大众汽车定点;蔚来也在寻找更多汽车及具身智能领域的合作伙伴。
对于没有整车业务提供基础用量的 XHEART,规模更加重要。
但客户增加,带来的不只是出货机会,还有不同的开发要求。
对车企而言,一颗芯片的意义不只是性能参数,还包括能否按时完成软件适配、系统验证和整车开发。更换芯片平台,往往意味着一整套工程流程需要重新确认。
如果供应商能够提前打通模型、芯片和域控制器之间的关键环节,车企需要承担的后期集成风险就有机会降低。
硬件集成上,不同车型对接口、散热、集成方式和安全架构的要求各不相同。XHEART 围绕 X7 系列提供 COB(Chip-on-Board,板上芯片)、SiP(System in Package,系统级封装)及双 X7 方案,让客户可以在已有设计基础上推进开发,减少部分重复工作。
算法适配也有类似的问题。客户可能采用外部算法,也可能坚持自研。即使都基于 Transformer,模型结构、算子组合与部署要求也可能存在差异。XHEART 独立销售 SoC,主机厂可以分别选择芯片和算法,也就是说,用 XHEART 的芯片,并不需要绑定 Momenta 的算法。
Momenta 提供的是量产模型的深度,XHEART 要守住的是芯片平台的开放性。
交付能力则要让客户选了之后,能够按时上车。XHEART 首颗 X7 芯片,从回片到整车闭环,只用了 17 天,而行业通常需要数月。
速度背后,是 XHEART 将部分原本需要回片后解决的问题,提前到了芯片研发阶段。
X7 流片之前,团队就与 Momenta 利用真实量产大模型开展了全芯片仿真验证。通过不同场景的数据,提前检查模型在预期架构上的运行情况,尽可能识别部分软硬件适配风险。
与此同时,XHEART 还与主机厂提前开展域控制器设计。
双方在芯片回片前,就开始推进相关器件的集成与验证准备。等芯片真正回来,模型、软件和域控系统已经有了前期开发基础。
X7 系列量产 8 个月,累计出货超过 20 万颗,搭载 10 款量产车型,并获得超过 40 款车型订单。
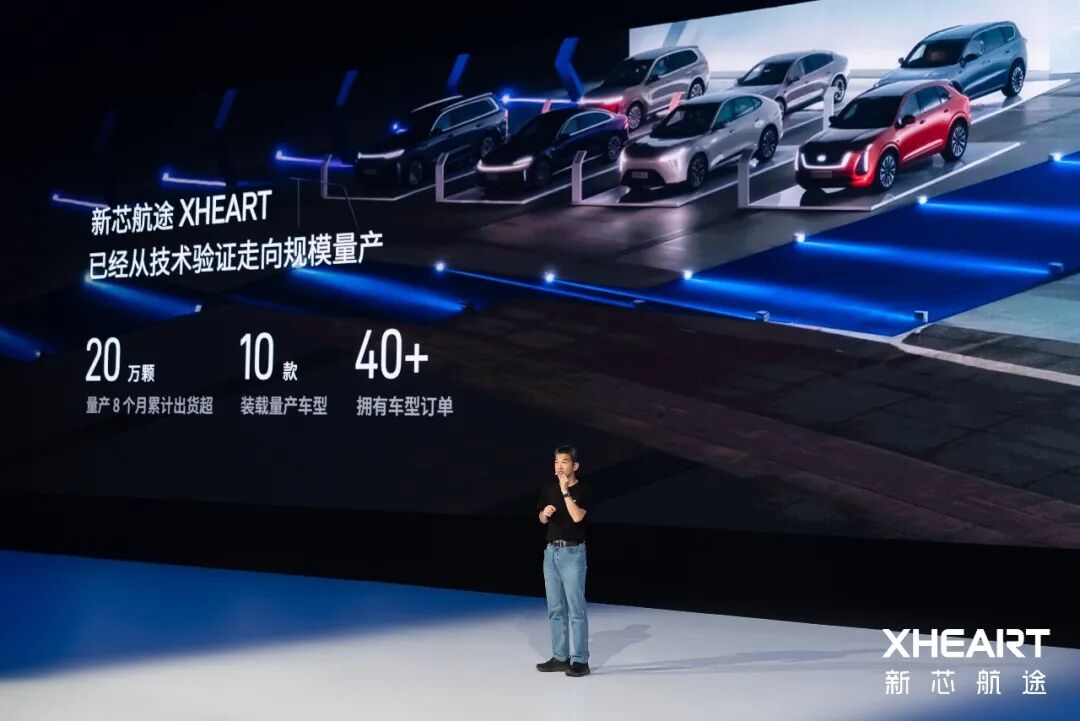
但放到整个汽车芯片行业,20 万颗仍然只是起点。
XHEART 需要将与 Momenta 合作中积累的模型优化方法,转化为更多客户可以复用的工具链和工程能力,才可能形成真正的规模效应。
而当智能驾驶进一步走向 L3、L4,这套体系还将面对更复杂的考验。
更高等级的自动驾驶,不只是需要更大的模型,还需要更严格的实时性、故障检测与安全冗余能力。
XHEART 已经推出基于双 X7 架构的 L3/L4 域控制器参考设计,并开始推进相关车型项目。
下一代 X9 也计划于 2027 年推出,目标大模型算力 3000 TOPS、单芯片内存带宽 700GB/s。
从当前量产走向下一代产品,未来真正的壁垒,将是持续理解模型、组织算力,以及服务不同车企的系统能力。
模型变化为后来者打开了入口。智驾芯片的下一轮竞争,正在从比拼纸面算力,走向比拼谁能让更强的大模型,以更高效率、更可控的成本,真正运行在更多量产汽车上。
三年前,「只有一次机会」的决定,变成了今天 20 万颗芯片的出货,而真正的大考,才刚刚开始。


参与评论
请您注册或者登录汽车之心社区账号即可发表回复
去登录
相关评论(共0条)
查看更多评论